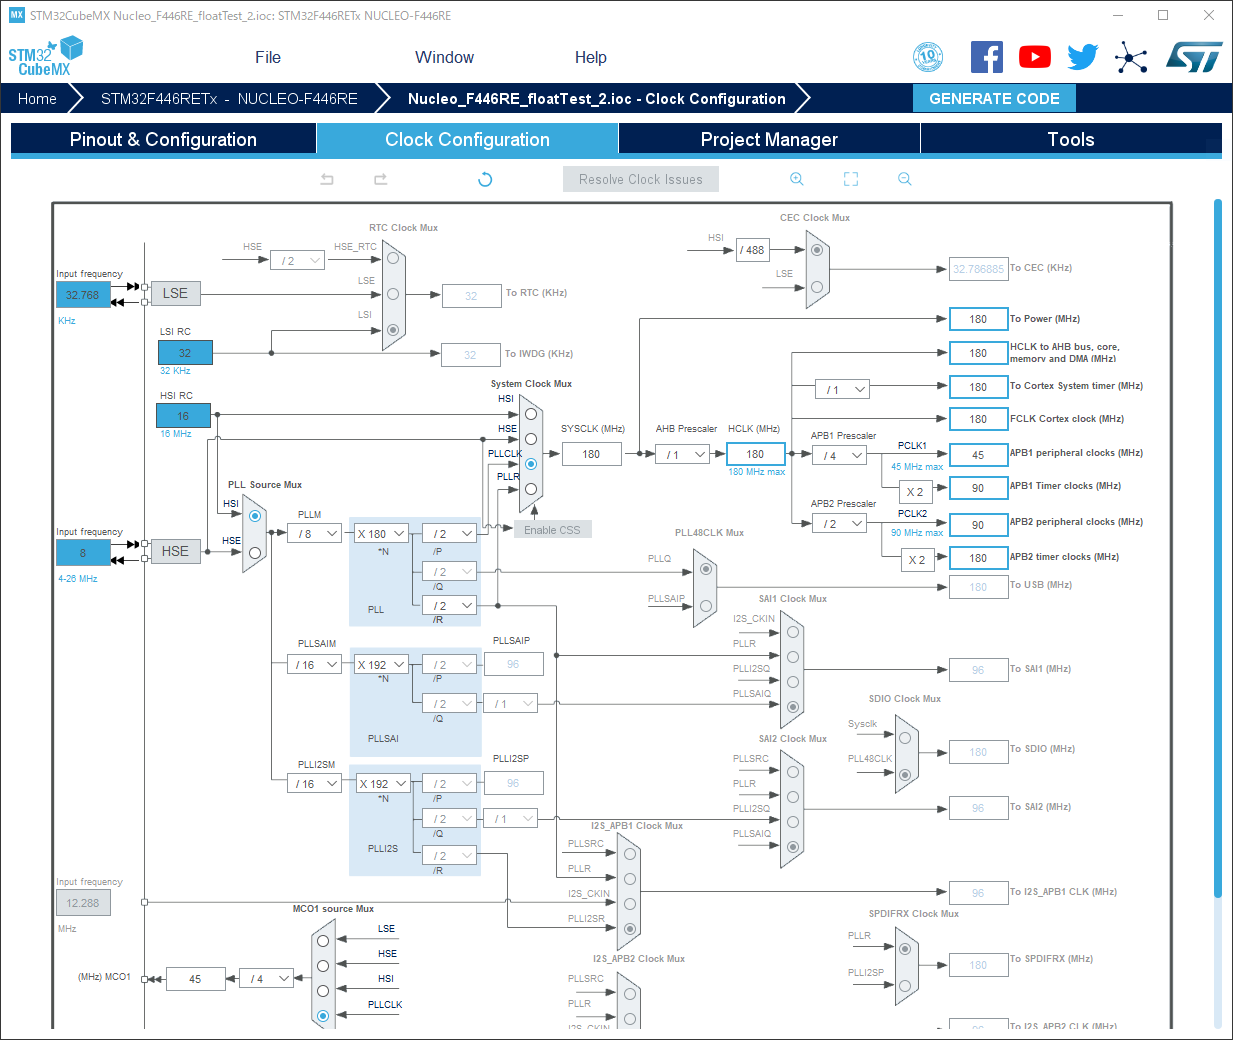
TrueSTUDIOも比較するのは大変なので、mbed OS5とSW4STM32+STM32Cubeで浮動小数点演算を再度比較してみました。
Github:
https://github.com/ryood/Nucleo_F446_FloatingPoint
mbedのDigitalOut::Write()とHAL_GPIO_WritePin()の差
まずは速度計測に使うGPIOをH/Lするのにかかる時間を比較しました。
mbed
#include "mbed.h"

DigitalOut CheckPin1(D2);

int main() {
 while (true) {
  CheckPin1 = 1;
  CheckPin1 = 0;
 }
}
SW4STM32(一部)
  /* Infinite loop */
  /* USER CODE BEGIN WHILE */
  while (1)
  {
    /* USER CODE END WHILE */

    /* USER CODE BEGIN 3 */
 HAL_GPIO_WritePin(CHK1_GPIO_Port, CHK1_Pin, GPIO_PIN_SET);
 HAL_GPIO_WritePin(CHK1_GPIO_Port, CHK1_Pin, GPIO_PIN_RESET);
  }
  /* USER CODE END 3 */
SW4STM32のコンパイルオプションで最適化を-O2にして測定しました。
Buildオプション
MCU GCC Compiler

-mcpu=cortex-m4 -mthumb -mfloat-abi=hard -mfpu=fpv4-sp-d16 -D__weak=__attribute__((weak)) -D__packed=__attribute__((__packed__)) -DUSE_HAL_DRIVER -DSTM32F446xx -I../Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc/Legacy -I../Drivers/CMSIS/Device/ST/STM32F4xx/Include -I../Drivers/CMSIS/Include -O2 -g3 -Wall -fmessage-length=0 -ffunction-sections -c -fmessage-length=0

MCU GCC Linker

-mcpu=cortex-m4 -mthumb -mfloat-abi=hard -mfpu=fpv4-sp-d16 -specs=nosys.specs -specs=nano.specs -T"../STM32F446RETx_FLASH.ld" -Wl,-Map=output.map -Wl,--gc-sections -lm
| GPIO Write |
処理時間(ns) |
Clock |
|---|
| mbed OS5 |
61.1 |
10.9 |
| HAL |
126.2 |
22.5 |
意外ですがHALよりmbedの方が速いようです。MPUを180MHz駆動すると1クロックの周期は 1 / 180MHz ≒ 5.6nsとなるので、それを元にClockを計算しました。
SW4STM32のデバッガのDiassemblyでは当該部分は以下のようになっています。
104           HAL_GPIO_WritePin(CHK1_GPIO_Port, CHK1_Pin, GPIO_PIN_SET);
080012f8:   mov     r4, r0
080012fa:   ldr     r3, [sp, #16]
080012fc:   bl      0x8000888 <HAL_GPIO_WritePin>
憶測ですが、HALの呼び出しはかなりコストが高いのかもしれません。STM32CubeにはLLというHALより低レベル(高速化が期待できる)のライブラリもありますが・・・
浮動小数点演算の比較
前回、mbedの空のループが速すぎましたが、float型の変数fvをvolatile指定していませんでした。volataile指定して最適化されないようにして計測し直しました。
mbed
#include "mbed.h"
#include <stdio.h>
#include <math.h>

#define PI_F (3.14159265f)
#define LOOP_N (1000)

DigitalOut CheckPin1(D2);

volatile float buffer[LOOP_N];

int main() {
    while (true) {
  CheckPin1 = 1;
  volatile float fv = 0.0f;
  for (int i = 0; i < LOOP_N; i++) {
   fv += 0.001f;
   //buffer[i] = fv + PI_F; // Add
   //buffer[i] = fv - PI_F; // Sub
   //buffer[i] = fv * PI_F; // Mul
   //buffer[i] = fv / PI_F; // Div
   buffer[i] = sinf(fv);
   //buffer[i] = cosf(fv);
   //buffer[i] = tanf(fv);
   //buffer[i] = expf(fv);
   //buffer[i] = logf(fv);
   //buffer[i] = powf(2.0f, fv);
  }
  CheckPin1 = 0;
    }
}
SW4STM32(一部)
  /* Infinite loop */
  /* USER CODE BEGIN WHILE */
  while (1)
  {
    /* USER CODE END WHILE */

    /* USER CODE BEGIN 3 */
 HAL_GPIO_WritePin(CHK1_GPIO_Port, CHK1_Pin, GPIO_PIN_SET);
 volatile float fv = 0.0f;
 for (int i = 0; i < LOOP_N; i++) {
  fv += 0.001f;
  //buffer[i] = fv + PI_F; // Add
  //buffer[i] = fv - PI_F; // Sub
  //buffer[i] = fv * PI_F; // Mul
  //buffer[i] = fv / PI_F; // Div
  buffer[i] = sinf(fv);
  //buffer[i] = cosf(fv);
  //buffer[i] = tanf(fv);
  //buffer[i] = expf(fv);
  //buffer[i] = logf(fv);
  //buffer[i] = powf(2.0f, fv);
 }
 HAL_GPIO_WritePin(CHK1_GPIO_Port, CHK1_Pin, GPIO_PIN_RESET);
  }
  /* USER CODE END 3 */
Buildオプション
MCU GCC Compiler

-mcpu=cortex-m4 -mthumb -mfloat-abi=hard -mfpu=fpv4-sp-d16 -D__weak=__attribute__((weak)) -D__packed=__attribute__((__packed__)) -DUSE_HAL_DRIVER -DSTM32F446xx -I../Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc/Legacy -I../Drivers/CMSIS/Device/ST/STM32F4xx/Include -I../Drivers/CMSIS/Include -O2 -g3 -Wall -fmessage-length=0 -ffunction-sections -c -fmessage-length=0

MCU GCC Linker

-mcpu=cortex-m4 -mthumb -mfloat-abi=hard -mfpu=fpv4-sp-d16 -specs=nosys.specs -specs=nano.specs -T"../STM32F446RETx_FLASH.ld" -Wl,-Map=output.map -Wl,--gc-sections -lm
測定データ(us)
| - |
mbed-cli |
SW4STM32 |
差 |
差2 |
|---|
| no-op |
39 |
49.6 |
10.6 |
|
| add |
77.8 |
99 |
21.2 |
10.6 |
| sub |
77.8 |
99 |
21.2 |
10.6 |
| mul |
77.8 |
99 |
21.2 |
10.6 |
| div |
145 |
165 |
20 |
9.4 |
| sinf() |
569 |
525 |
-44 |
-54.6 |
| cosf() |
621 |
591 |
-30 |
-40.6 |
| tanf() |
986 |
966 |
-20 |
-30.6 |
| expf() |
958 |
974 |
16 |
5.4 |
| logf() |
946 |
998 |
52 |
41.4 |
| powf() |
2625 |
2735 |
110 |
99.4 |
測定データの「差2」はGPIO出力の処理時間の差を考慮したmbedとSW4STM32の処理時間の差です。GPIO分を差し引いても四則演算ではmbedの方が速いです。アセンブラレベルで比較すれば何かわかるかもしれませんが、深みにハマりそうなのでやめておきます。