製作モジュール一覧

2019年3月7日木曜日

GPIO出力の速度比較 mbed OS5 vs HAL API vs LL API

しつこくGPIO出力の速度を比較します。STM32CubeのHAL APIより低レベルのLL APIも測定しました。

LL APIについてはYKb::Logさんの「STM32でLL APIを使ってみる」を参考にしました。
  • mbed-cli Version: 1.9.1
  • STM32CubeMX Version: 5.1.0
  • System Workbench for STM32 - C/C++ Embedded Development Tools for MCU Version: 2.7.2.201812190825
HALとLLはコンパイラオプションで-O2を指定しました。

mbed OS5

#include "mbed.h"

DigitalOut CheckPin1(D2);

int main() {
 while (true) {
  CheckPin1 = 1;
  CheckPin1 = 0;
 }
}

HAL API(一部)

  /* Infinite loop */
  /* USER CODE BEGIN WHILE */
  while (1)
  {
    /* USER CODE END WHILE */

    /* USER CODE BEGIN 3 */
 HAL_GPIO_WritePin(CHK1_GPIO_Port, CHK1_Pin, GPIO_PIN_SET);
 HAL_GPIO_WritePin(CHK1_GPIO_Port, CHK1_Pin, GPIO_PIN_RESET);
  }
  /* USER CODE END 3 */

LL API(一部)

  /* Infinite loop */
  /* USER CODE BEGIN WHILE */
  while (1)
  {
    /* USER CODE END WHILE */

    /* USER CODE BEGIN 3 */
 LL_GPIO_SetOutputPin(CHK1_GPIO_Port, CHK1_Pin);
 LL_GPIO_ResetOutputPin(CHK1_GPIO_Port, CHK1_Pin);
  }
  /* USER CODE END 3 */

STM32CubeMXで、GPIOの「Maximum ouput speed」を「Very High」に設定。


ソースコードの「static void MX_GPIO_Init(void)」に反映されます。

  /*Configure GPIO pin : CHK1_Pin */
  GPIO_InitStruct.Pin = CHK1_Pin;
  GPIO_InitStruct.Mode = GPIO_MODE_OUTPUT_PP;
  GPIO_InitStruct.Pull = GPIO_NOPULL;
  GPIO_InitStruct.Speed = GPIO_SPEED_FREQ_VERY_HIGH;  // <- Here
  HAL_GPIO_Init(CHK1_GPIO_Port, &GPIO_InitStruct);

LL APIはプロジェクト全体をLL APIにしなきゃいけないかと思っていましたが、HALと混在できるようです。LL APIを使用するには、STM32CubeMXの「Project Manager」-「Advanced Setting」でDriverごとに個別に設定できます。


mbed OS5

HAL API

LL API

- 処理時間(us) clock数
mbed OS5 61.09 11.0
HAL API 126.6 22.8
LL API 59.67 10.7

※クロック数はMPUの駆動クロックの180MHzをオシロの表示値で割って求めました。

LL APIを使ってやっとmbed OS5と同じ程度の処理時間になりました。LL APIの波形を見るとHよりLの時間が長くなっています。これはwhile()ループの処理がオーバーヘッドとなっているためだと思いますが、mbedの場合はそのような兆候は見られません。

いやはや、mbedの処理速度はあっぱれだと思います。

2019年3月4日月曜日

浮動小数点数演算の速度比較 mbed OS5 vs TureSTUDIO vs SW4STM32 その2

TrueSTUDIOも比較するのは大変なので、mbed OS5とSW4STM32+STM32Cubeで浮動小数点演算を再度比較してみました。

Github:
https://github.com/ryood/Nucleo_F446_FloatingPoint

mbedのDigitalOut::Write()とHAL_GPIO_WritePin()の差


まずは速度計測に使うGPIOをH/Lするのにかかる時間を比較しました。

mbed

#include "mbed.h"

DigitalOut CheckPin1(D2);

int main() {
 while (true) {
  CheckPin1 = 1;
  CheckPin1 = 0;
 }
}

SW4STM32(一部)

  /* Infinite loop */
  /* USER CODE BEGIN WHILE */
  while (1)
  {
    /* USER CODE END WHILE */

    /* USER CODE BEGIN 3 */
    HAL_GPIO_WritePin(CHK1_GPIO_Port, CHK1_Pin, GPIO_PIN_SET);
    HAL_GPIO_WritePin(CHK1_GPIO_Port, CHK1_Pin, GPIO_PIN_RESET);
  }
  /* USER CODE END 3 */

SW4STM32のコンパイルオプションで最適化を-O2にして測定しました。

Buildオプション

MCU GCC Compiler

-mcpu=cortex-m4 -mthumb -mfloat-abi=hard -mfpu=fpv4-sp-d16 -D__weak=__attribute__((weak)) -D__packed=__attribute__((__packed__)) -DUSE_HAL_DRIVER -DSTM32F446xx -I../Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc/Legacy -I../Drivers/CMSIS/Device/ST/STM32F4xx/Include -I../Drivers/CMSIS/Include -O2 -g3 -Wall -fmessage-length=0 -ffunction-sections -c -fmessage-length=0

MCU GCC Linker

-mcpu=cortex-m4 -mthumb -mfloat-abi=hard -mfpu=fpv4-sp-d16 -specs=nosys.specs -specs=nano.specs -T"../STM32F446RETx_FLASH.ld" -Wl,-Map=output.map -Wl,--gc-sections -lm

GPIO Write 処理時間(ns) Clock
mbed OS5 61.1 10.9
HAL 126.2 22.5

意外ですがHALよりmbedの方が速いようです。MPUを180MHz駆動すると1クロックの周期は 1 / 180MHz ≒ 5.6nsとなるので、それを元にClockを計算しました。

SW4STM32のデバッガのDiassemblyでは当該部分は以下のようになっています。

104           HAL_GPIO_WritePin(CHK1_GPIO_Port, CHK1_Pin, GPIO_PIN_SET);
080012f8:   mov     r4, r0
080012fa:   ldr     r3, [sp, #16]
080012fc:   bl      0x8000888 <HAL_GPIO_WritePin>

憶測ですが、HALの呼び出しはかなりコストが高いのかもしれません。STM32CubeにはLLというHALより低レベル(高速化が期待できる)のライブラリもありますが・・・

浮動小数点演算の比較


前回、mbedの空のループが速すぎましたが、float型の変数fvをvolatile指定していませんでした。volataile指定して最適化されないようにして計測し直しました。

mbed

#include "mbed.h"
#include <stdio.h>
#include <math.h>

#define PI_F (3.14159265f)
#define LOOP_N (1000)

DigitalOut CheckPin1(D2);

volatile float buffer[LOOP_N];

int main() {
    while (true) {
  CheckPin1 = 1;
  volatile float fv = 0.0f;
  for (int i = 0; i < LOOP_N; i++) {
   fv += 0.001f;
   //buffer[i] = fv + PI_F; // Add
   //buffer[i] = fv - PI_F; // Sub
   //buffer[i] = fv * PI_F; // Mul
   //buffer[i] = fv / PI_F; // Div
   buffer[i] = sinf(fv);
   //buffer[i] = cosf(fv);
   //buffer[i] = tanf(fv);
   //buffer[i] = expf(fv);
   //buffer[i] = logf(fv);
   //buffer[i] = powf(2.0f, fv);
  }
  CheckPin1 = 0;
    }
}

SW4STM32(一部)

  /* Infinite loop */
  /* USER CODE BEGIN WHILE */
  while (1)
  {
    /* USER CODE END WHILE */

    /* USER CODE BEGIN 3 */
 HAL_GPIO_WritePin(CHK1_GPIO_Port, CHK1_Pin, GPIO_PIN_SET);
 volatile float fv = 0.0f;
 for (int i = 0; i < LOOP_N; i++) {
  fv += 0.001f;
  //buffer[i] = fv + PI_F; // Add
  //buffer[i] = fv - PI_F; // Sub
  //buffer[i] = fv * PI_F; // Mul
  //buffer[i] = fv / PI_F; // Div
  buffer[i] = sinf(fv);
  //buffer[i] = cosf(fv);
  //buffer[i] = tanf(fv);
  //buffer[i] = expf(fv);
  //buffer[i] = logf(fv);
  //buffer[i] = powf(2.0f, fv);
 }
 HAL_GPIO_WritePin(CHK1_GPIO_Port, CHK1_Pin, GPIO_PIN_RESET);
  }
  /* USER CODE END 3 */

Buildオプション

MCU GCC Compiler

-mcpu=cortex-m4 -mthumb -mfloat-abi=hard -mfpu=fpv4-sp-d16 -D__weak=__attribute__((weak)) -D__packed=__attribute__((__packed__)) -DUSE_HAL_DRIVER -DSTM32F446xx -I../Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc/Legacy -I../Drivers/CMSIS/Device/ST/STM32F4xx/Include -I../Drivers/CMSIS/Include -O2 -g3 -Wall -fmessage-length=0 -ffunction-sections -c -fmessage-length=0

MCU GCC Linker

-mcpu=cortex-m4 -mthumb -mfloat-abi=hard -mfpu=fpv4-sp-d16 -specs=nosys.specs -specs=nano.specs -T"../STM32F446RETx_FLASH.ld" -Wl,-Map=output.map -Wl,--gc-sections -lm


測定データ(us)

- mbed-cli SW4STM32 差 差2
no-op 39 49.6 10.6
add 77.8 99 21.2 10.6
sub 77.8 99 21.2 10.6
mul 77.8 99 21.2 10.6
div 145 165 20 9.4
sinf() 569 525 -44 -54.6
cosf() 621 591 -30 -40.6
tanf() 986 966 -20 -30.6
expf() 958 974 16 5.4
logf() 946 998 52 41.4
powf() 2625 2735 110 99.4

測定データの「差2」はGPIO出力の処理時間の差を考慮したmbedとSW4STM32の処理時間の差です。GPIO分を差し引いても四則演算ではmbedの方が速いです。アセンブラレベルで比較すれば何かわかるかもしれませんが、深みにハマりそうなのでやめておきます。


2019年3月2日土曜日

浮動小数点数演算の速度比較 mbed OS5 vs TureSTUDIO vs SW4STM32

STM32Cube + TrueSTUDIOでいろいろ試していましたが、Buildの設定を「Debug」ではなく、「Release」にするとアラートが表示されます。


「Orphaned configuraion. ...」というアラートメッセージで検索するとCubeMXの次期バージョンで対応とかなんとか出てきますがよくわかりません。

TrueSTUDIOと同じく無償のSTM32の開発環境のSW4STM32も少し使ってみました。

SW4STM32について


「System Workbench for STM32」の略称で、「Atollic TrueSTUDIO」と同じくEclipseベースの統合開発環境です。

STM32CubeMXでプログラムの雛形を作るとTrueSTUDIOでもSW4STM32でも簡単なプログラムを書く場合はそれほど違いがありません。

参考にした記事

「電子工作専科」さんの「System workbench for STM32」

Nucloe-F446REで単精度浮動小数点数演算の速度比較


今まで、mbedを使ってきましたが、STM32のネイティブ環境であるTrueSTUDIOとSW4STM32で単精度浮動小数点数演算の速度を比較しました。
  • STM32CubeMX Version: 5.1.0
  • TrueSTUDIO for STM32 Version: 9.3.0
  • System Workbench for STM32 - C/C++ Embedded Development Tools for MCU Version: 2.7.2.201812190825
  • mbed-cli Version: 1.9.1
整理できていないのでmbed-cliのプログラムだけ

#include "mbed.h"
#include <stdio.h>
#include <math.h>

#define PI_F (3.14159265f)
#define LOOP_N (1000)

DigitalOut CheckPin1(D2);

volatile float buffer[LOOP_N];

int main() {
    while (true) {
  CheckPin1 = 1;
  float fv = 0.0f;
  for (int i = 0; i < LOOP_N; i++) {
   fv += 0.001f;
   //buffer[i] = fv + PI_F; // Add
   //buffer[i] = fv - PI_F; // Sub
   //buffer[i] = fv * PI_F; // Mul
   //buffer[i] = fv / PI_F; // Div
   buffer[i] = sinf(fv);
   //buffer[i] = cosf(fv);
   //buffer[i] = tanf(fv);
   //buffer[i] = expf(fv);
   //buffer[i] = logf(fv);
   //buffer[i] = powf(2.0f, fv);
  }
  CheckPin1 = 0;
    }
}

float型の演算結果をbufferに代入するのを1000回繰り返し、その前後でGPIOの出力をH/Lさせています。それぞれの演算はコメントアウトしたり外したりして再ビルドするという地道な方法で測定しました。


測定データ(us)

/ TrueSTUDIO SW4STM32 mbed-cli
no-op 22.15 22.15 0.06108
add 77 82.6 44.5
sub 82 82.4 44.5
mul 82.6 82.6 44.5
div 138 137 111
sinf() 547 515 536
cosf() 607 581 588
tanf() 1050 1002 926
expf() 990 1122 926
logf() 934 982 906
powf() 4090 2995 2585

「no-op」というのはbufferへの代入を全てコメントアウトして、「fv += 0.001f;」という演算のみでループさせた場合です。mbed-cli(グレーの縦棒)では処理が速すぎてグラフに表示されていません。

mbed

TrueSTUDIO

SW4STM32

mbedよりSTM32のネイティブ環境の方が速くなるんではないかと思っていたのですが、mbedの方が高速という結果です。

mbedの場合は1000回演算を16MHzで処理してるので、180MHz駆動ではあからさまにおかしいと思いますが、最適化の具合?

TrueSTUDIO/SW4STM32のコンパイル/リンクオプション


TrueSTUDIO
[C Compiler]
Command: arm-atollic-eabi-gcc -c
All options:
-mthumb -mcpu=cortex-m4 -mfloat-abi=hard -mfpu=fpv4-sp-d16 -std=gnu11 -D__weak=__attribute__((weak)) -D__packed=__attribute__((__packed__)) -DUSE_HAL_DRIVER -DSTM32F446xx -I../Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc/Legacy -I../Drivers/CMSIS/Device/ST/STM32F4xx/Include -I../Drivers/CMSIS/Include -Og -ffunction-sections -fdata-sections -g -fstack-usage -Wall -specs=nano.specs
[C Linker]
-mthumb -mcpu=cortex-m4 -mfloat-abi=hard -mfpu=fpv4-sp-d16 -std=gnu11 -D__weak=__attribute__((weak)) -D__packed=__attribute__((__packed__)) -DUSE_HAL_DRIVER -DSTM32F446xx -I../Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc/Legacy -I../Drivers/CMSIS/Device/ST/STM32F4xx/Include -I../Drivers/CMSIS/Include -Og -ffunction-sections -fdata-sections -g -fstack-usage -Wall -specs=nano.specs

SW4STM32
[MCU GCC Compiler]
Command: gcc
All options:
-mcpu=cortex-m4 -mthumb -mfloat-abi=hard -mfpu=fpv4-sp-d16 -D__weak=__attribute__((weak)) -D__packed=__attribute__((__packed__)) -DUSE_HAL_DRIVER -DSTM32F446xx -I../Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc -I../Drivers/STM32F4xx_HAL_Driver/Inc/Legacy -I../Drivers/CMSIS/Device/ST/STM32F4xx/Include -I../Drivers/CMSIS/Include -Og -g3 -Wall -fmessage-length=0 -ffunction-sections -c -fmessage-length=0
[MCU GCC Linker]
Command: gcc
All options:
-mcpu=cortex-m4 -mthumb -mfloat-abi=hard -mfpu=fpv4-sp-d16 -specs=nosys.specs -specs=nano.specs -u _printf_float -T"../STM32F446RETx_FLASH.ld" -Wl,-Map=output.map -Wl,--gc-sections -lm

TrueSTUDIOで「Add」した場合のウオッチ

誤差は出ていますが、πの値に0.001ずつ加算されていると思います。

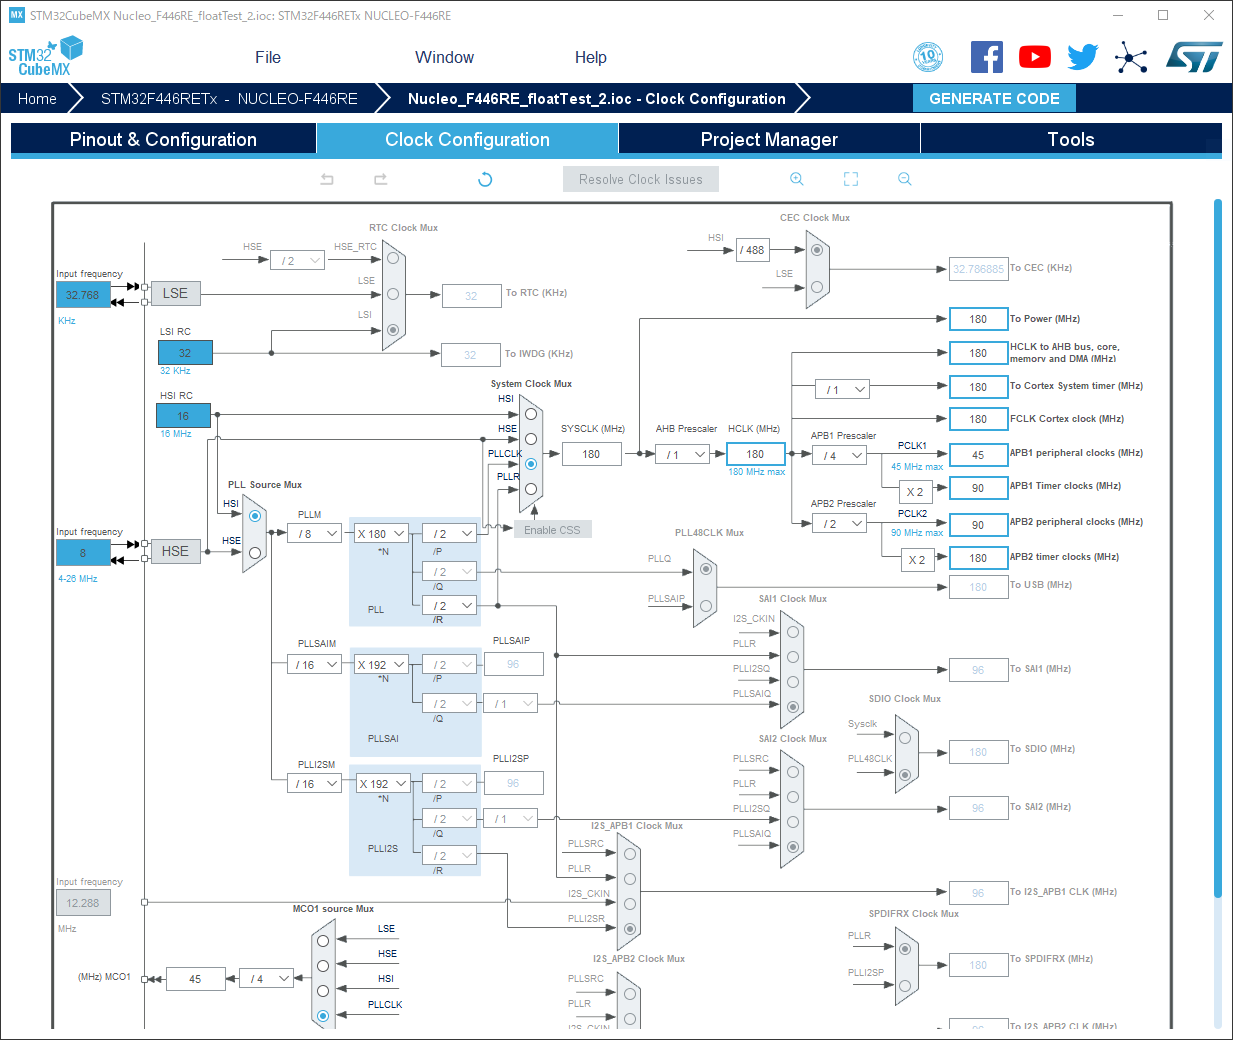
STM32CubeMXでNucleo-F446REは180MHz駆動する設定にしています。


メモ:


TrueSTUDIOでは、sprintf()でfloatを使うときは、[General]-[Runtime Library]で[Newlib standard]を選択する。


IDEでのFPUの設定


CMSIS DSPにFAST MATH FUNCTIONがあるが、sine/cosine/sqrtのみ。DSPはベクトル演算で本領を発揮するので、関係はなさそう。