製作モジュール一覧

ラベル Nucleo F767ZI の投稿を表示しています。 すべての投稿を表示

2018年9月16日日曜日

Nucleo F767ZIでmbed 2とmbed OS 5の浮動小数点数演算の速度を比較

Nucleo F767ZIでオンラインコンパイラのmbed 2と、mbed-cliのmbed OS 5の浮動小数点数演算の処理時間を測定しました。

テストプログラム
https://github.com/ryood/Nucleo_DCO/tree/master/mbed/FloatingPoint_Test01

測定結果

青とオレンジがfloat型の演算結果で、グレーと黄色がdouble型の演算結果です。

add, sub, mul, divはそれぞれ加算、減算、乗算、除算で圧倒的にfloat型が高速です。

ところが、なぜだがか三角関数や指数関数のsin, cos, exp, logは、float型とdouble型の差があまりありません。

DDSのチューニングワードを計算する
// calc tuning word
    t.reset();
    t.start();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = pow(2.0, 32) * (double)i / 100000.0;
    }
    t.stop();
    elapse = t.read_us();
    pc.printf("tword\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);
という演算では、むしろmbed OS 5のdouble型(グラフではtwordのグレイ)が最速となっています。「pow(2.0, 32)」という項は定数なので、この場合最適化されているのかもしれません。

Nucleo F767ZIをmbedで使った場合に限りますが、浮動小数点数演算の四則演算はfloat型でやったほうが速く、三角関数や指数関数(特にDDSがらみの演算)はdouble型でやってもそれほど遅くないと言えると思います。

測定データ

op OS 5 float Mbed 2 float OS 5 double Mbed 2 double
add 0.03708 0.02549 2.23522 1.64085
sub 0.07417 0.04866 2.29228 1.684
mul 0.11125 0.07416 2.36179 1.7396
div 0.21784 0.16682 2.54717 1.90871
sin 0.55664 0.37082 0.88683 0.93309
cos 0.59404 0.35549 0.95088 1.11853
exp 0.76539 0.53734 1.16889 1.04258
log 0.82766 0.48837 1.2759 1.36975
sqrt 1.31143 0.22935 3.23866 0.37065
pow32 2.28002 1.59155 0.6069 3.92082
tword 2.1812 1.60074 0.21782 3.48061

<追記:2018.09.16>

mbed-cliのOS 5とオンラインコンパイラのmbed 2で分けてグラフ化しました。

Mbed OS 5

Mbed 2

</追記>

2018年8月19日日曜日

Nucleo DCOの構想 ~ いわゆるプロダクト・アウト

需要ははあまりなさそうなテーマですが、Arduino LFOと同じような仕組みでハイスペックなNucleoF767でDCOを試作したいと思います。

OTAを使ったVCAのDual OTA VCA、トランジスターラダーLPFのTLF01とアナログ回路で組んできたので、VCOもアナログ回路で組みたいところですが、一度、音源として汎用的に使えそうなデジタル・オシレーターを作ってみようと思います。

Arduino + MCP4922ではいいとこLFO程度が上限でしたが、Nucleo F767なら12bit DACを内蔵、動作クロック216MHz、double型のFPU内蔵、メモリも潤沢(Flash 2MB/RAM 512kB)、mbedでプログラミング可ということでNucleo F767をコアとして試作することにしました。

仕様案


1) 内蔵12bit DAC 1ch出力

Nucleo F767は2ch分のDACが内蔵されていますが、1つはオンボードのLEDと接続されていて出力波形が汚いので1chのみとします。

参考「Nucleo F446RE 内蔵DACのテスト

2) サンプリング・レート 48kHz以上

最低でも48kHzとします。12bit/48kHzなので20年ぐらい前のサンプラー相当です。

I2Sならオーディオ品質のDACを使えますが、とりあえず楽をする方向で考えます。I2SはPSoC 5LPで使ったことがありますが、NucleoやESP32で使ったことがないので後々。

参考「オーディオ用DACを使ったファンクションジェネレータ まとめ

3) 出力波形

SQR、SAWUP、SAWDOWN、TRI、SIN、NOISE。Arduino LFOでは計算時間が足りなくてNoiseは出力できませんでしたがNucleoならできそうです。

4) 3オシレーター

1オシレーターだと音が薄いので、3オシレーターをプログラム上でMIXして出力します。サンプリングレートを下げていけばできそうな気がしますが、問題は操作子が増えることです。1オシレーターで妥協するかもしれません。1~2オクターブ下の周波数を出力するサブオシレーターにするかも?出音を比較しつつ。

5) 出力周波数

ピアノの音階の27.5Hz~4,186Hzより広くするつもりです。POTの解像度が10bit(1024)程度しかないので、レンジ切り替えで対応すると思います。

6) 出力電圧

最低、-∞ ~ ±2.5V程度で考えています。DC成分のない両電源波形です。

1オシレーターの場合のブロック図

ほとんどArduino LFOと同じ構成ですが、両電源波形にするためDAC出力をACカップリングしています。プッシュスイッチを使ってレンジ、波形を切り替えると、フィードバックが必要になるので表示器としてLCDかOLEDを使うつもりです。

ロータリースイッチを使えば表示器は不要ですが、線数が増えまくります。

Phase POTは位相を可変するもので、1オシレーターだとあまり意味はがないんですが、複数あればオシレーターごとに位相をずらしてうねりをつくれます。

外観案


1オシレーターならこれぐらいのサイズで収まりそうです。3オシレーターにしようと思うとPOTx16 PizzaBoxぐらいの規模になりそうです。

内蔵DACからの出力波形


1kHzのサイン波を出力するプログラムを書いて出力波形を見てみました。サンプリングレートはとりあえず100kHzにしました。

DDSにつかうWaveテーブルは32,768要素にしました。簡単に出力テストしてみると、これ以上要素数を増やしてもあんまり効果はなさそうでしたが、メモリーが潤沢なので要素数は増やせます。

mbed Repository
https://os.mbed.com/users/ryood/code/Nucleo-F767_DCO_Test01/

処理時間の計測

ch1:D4 ch2:D5

ch1:D4はメインループ内で1マイクロ秒のWaitをかけてH/Lしていて、ch2:D5はサンプリング周期毎の割り込み処理の最初と最後でH/Lしています。

サンプリングレートが100kHzなのでch2の周波数は100kHzになっています。Hになっている時間(PW)は720.0nsでまずまず計算する時間の余裕はありそうです。

オシロで見ると、ch2の波形が多少ブルブル震えています。←ジッターあり。

ch1は、ch2の割り込みのタイミングで1マイクロ秒より引き伸ばされる場合があります。

以下、電源ノイズを避けるために、NucleoのUSB電源を電池使用の安定化電源にして測定しました。


出力波形

普通に内蔵DACで出力すると波形の上下でクリップするので、ファームウェアで小細工して3Vp-p弱の振幅にしました。ファームウェアの以下の部分です。

    //uint16_t v = val << 4;
    // avoid distortion of the built-in DAC
    uint16_t v = (val + 256) * 14;

出力波形(拡大)

ガタガタの幅は10usで、逆数は100kHzなのでサンプリングレートと合致します。

FFT

横軸は25kHz/DIVで100kHzと200kHz付近にエイリアスが現れています。

WaveSpectra

Audio Interface: TASCAM US-144II、MIC/LINE入力、24bit/96kHz
窓関数: Flat Top

THD: 0.03635%
THD+N: 0.19748%

出力にLPFをかけるにしても可聴帯域の20kHzあたり以下の帯域は通過域です。

メモ:


Nucleo F767のZIOヘッダは、Arduinoのシールドを使うと内側の穴が隠れてしまって使いづらい。

サンプリングレートを決めてからLPFを設計する。

MIDI対応できるように考えておく。

SyncIn必要?

2017年11月26日日曜日

Raspberry Pi 3とCortex-M7のNucleo F767ZIの浮動小数点演算を比較

Nucleo用にmbedで書いたプログラムとほぼおなじものをRaspberry Pi3用にC++で書いて比較してみた。

Nucleo用プログラム (mbed)
https://os.mbed.com/users/ryood/code/FloatingPointTest/ Revison:1

Raspberry Pi 3用プログラム <floating_point_test.cc>

#include <stdio.h>
#include <math.h>
#include <time.h>
#include <stdint.h>

#define LOOP_N  (10000)

float buffer[LOOP_N];

clock_t start;

void floatTest()
{
    // divf
    start = clock();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = (float)i / LOOP_N;
    }
    int elapse = clock() - start;
    printf("divf\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);
    
    // sinf
    start = clock();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = sinf((float)i / LOOP_N);
    }
    elapse = clock() - start;
    printf("sinf\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);

    // cosf
    start = clock();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = cosf((float)i / LOOP_N);
    }
    elapse = clock() - start;
    printf("cosf\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);

    // expf
    start = clock();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = expf((float)i / LOOP_N);
    }
    elapse = clock() - start;
    printf("expf\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);
    
    // logf
    start = clock();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = logf((float)i / LOOP_N);
    }
    elapse = clock() - start;
    printf("logf\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);
    
    // sqrtf
    start = clock();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = sqrtf((float)i / LOOP_N);
    }
    elapse = clock() - start;
    printf("sqrtf\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);      
}

void doubleTest()
{
    // div
    start = clock();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = (double)i / LOOP_N;
    }
    int elapse = clock() - start;
    printf("div\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);
    
    // sin
    start = clock();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = sin((double)i / LOOP_N);
    }
    elapse = clock() - start;
    printf("sin\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);

    // cos
    start = clock();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = cos((double)i / LOOP_N);
    }
    elapse = clock() - start;
    printf("cos\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);

    // exp
    start = clock();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = exp((double)i / LOOP_N);
    }
    elapse = clock() - start;
    printf("exp\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);
    
    // log
    start = clock();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = log((double)i / LOOP_N);
    }
    elapse = clock() - start;
    printf("log\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);
    
    // sqrt
    start = clock();
    for (int i = 0; i < LOOP_N; i++) {
        buffer[i] = sqrt((double)i / LOOP_N);
    }
    elapse = clock() - start;
    printf("sqrt\t%d\t%f\r\n", elapse, (float)elapse / LOOP_N);      
}

int main()
{
    printf("\nFloating Point Test\n");
    printf("CLOCKS_PER_SEC: %ld\n", CLOCKS_PER_SEC); 
    
    // 単精度浮動小数点演算
    printf("\nFloating Point Test\n");
    printf("float\n");
    printf("op\ttotal\t1-op\n");
    printf("-------------------------------\n");
    floatTest();
    
    // 倍精度浮動小数点演算
    printf("double\n");
    printf("op\ttotal\t1-op\n");
    printf("-------------------------------\n");
    doubleTest();
}


pi@raspberrypi:~ $ gcc -o floating_point_test -lm floating_point_test.cc

pi@raspberrypi:~ $ cat /etc/debian_version
8.0

Raspberry PiのプログラムはLinux上で実行しているのでNucleoの方が有利ですが、Raspberry PiをOSなし(ベアメタルと言うそうです)で動かすのはかなり難しいので、実用的な性能比較ということになると思います。

実行結果

Floating Point Test
CLOCKS_PER_SEC: 1000000

Floating Point Test
float
op      total   1-op
-------------------------------
divf    629     0.062900
sinf    2124    0.212400
cosf    2163    0.216300
expf    3632    0.363200
logf    2659    0.265900
sqrtf   3630    0.363000
double
op      total   1-op
-------------------------------
div     753     0.075300
sin     4805    0.480500
cos     4829    0.482900
exp     5356    0.535600
log     4408    0.440800
sqrt    4871    0.487100

※Raspberry Pi上では実行ごとに結果が異なる。


float型ではsqrtf()以外ではNucleo F767はRasPi3の約0.6倍の性能。なぜだかsqrtf()だけはNucleo F767の方が速い。

double型ではsqrt()以外はNucleo F767はRasPi3の約0.2倍~0.5倍の性能。これもsqrt()はNucleo F767の方が速い。

駆動クロックは

Nucleo F767ZI: 216MHz
Raspberry Pi 3: 1.2GHz

で約6倍差があるので、Cortex-M7のNucleo F767ZIは、まあまあ健闘していると思う。

Nucleo F767ZIの消費電流は98mAで(ボード上のJP5 IDDで測定)、Raspberry Pi 3よりかなり少ない。

2017年11月19日日曜日

Nucleo F767ZI 浮動小数点演算の比較

Cortex-M7のNucleo F767ZIを買ってみた。

RS-Onlineで発注して到着まで3日。佐川急便で届いたので国内で再発送してるような感じです。

サイズ


左上がArduino Uno Rev.3、右上がNucleo F446RE、下がNucleo F767ZI。ボードもでかいが144PinのMCUもでかい。

ST Link側のUSBコネクタはmicro-USB(Nucleo F446REなどのNucleo64はmini-USB)。本体側にも別にmicro-USB端子がついていて、有線LAN用のRJ45ジャックもついている。

GPIO等のコネクタは、Aruduino Headerを2列にしたようなZIO Headerと、その外側にmorpho Header(ピンヘッダは実装されていない)がある。

なかなか豪勢な仕様で、お値段3000円しないのでコスパはいいように思う。

浮動小数点演算


Nulceo F401/F446/F303でやったのと同じように浮動小数点演算を試してみた。

Nucleo F767ZIは単精度浮動小数点数ではなく倍精度浮動小数点数のFPUがついているので、F446とF767でそれぞれ比較してみた。

mbed Repository:
https://os.mbed.com/users/ryood/code/FloatingPointTest/ Revision:1

測定結果


F446 float
op total 1-op
-------- -------- ---------------
divf 1168 0.1168
sinf 4939 0.4939
cosf 4665 0.4665
expf 6758 0.6758
logf 6140 0.614
sqrtf 2392 0.2392

F446 double
op total 1-op
-------- -------- ---------------
div 10754 1.0754
sin 94134 9.4134
cos 110762 11.0762
exp 105595 10.5595
log 137396 13.7396
sqrt 16633 1.6633

F767 float
op total 1-op
-------- -------- ---------------
divf 974 0.0974
sinf 3690 0.369
cosf 3532 0.3532
expf 5374 0.5374
logf 4884 0.4884
sqrtf 2294 0.2294

F767 double
op total 1-op
-------- -------- ---------------
div 3985 0.3985
sin 9511 0.9511
cos 11023 1.1023
exp 10358 1.0358
log 13603 1.3603
sqrt 3730 0.373


float型ではF767の方が若干処理が速くなっていて、double型ではかなり差がついている。

F446の駆動クロックは180MHzで、F767は216MHzなので、float型ではクロック分速いぐらいか。

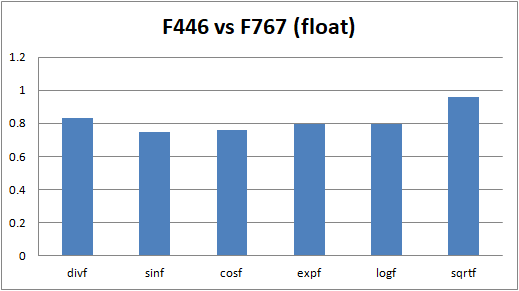
F446とF767で処理速度の比をグラフ化してみた。


float型ではおおよそ0.8程度。180MHz / 216MHz ≒ 0.83。

double型では、div(割り算)とsqrt以外ではおおよそ0.1程度になっている。

Cortex-M7なので、float型でも速くなってて欲しいな~と思っていましたが、クロック分しか速くなっていない。

Cortex-Aで1.2GHz駆動のRapberry Pi3ぐらいは行ってほしかったのですが。